慧通 · 数据智理解决方案
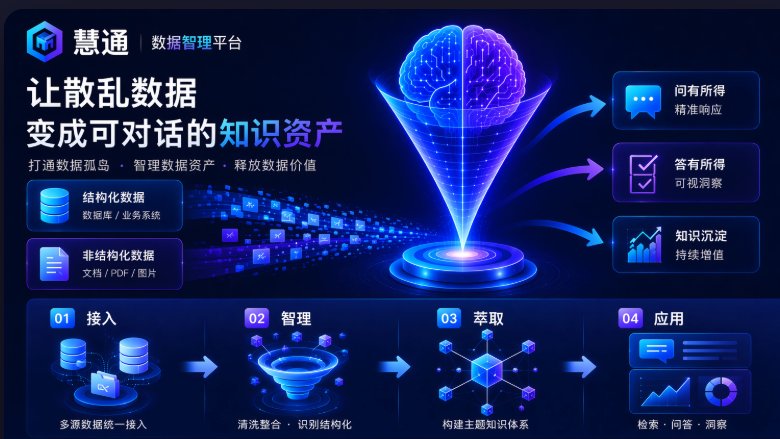
一句话定位: 让散落各处的数据自动汇聚、清洗、贯通,沉淀为按主题、可随时调用的知识资产——理得清,用得好。
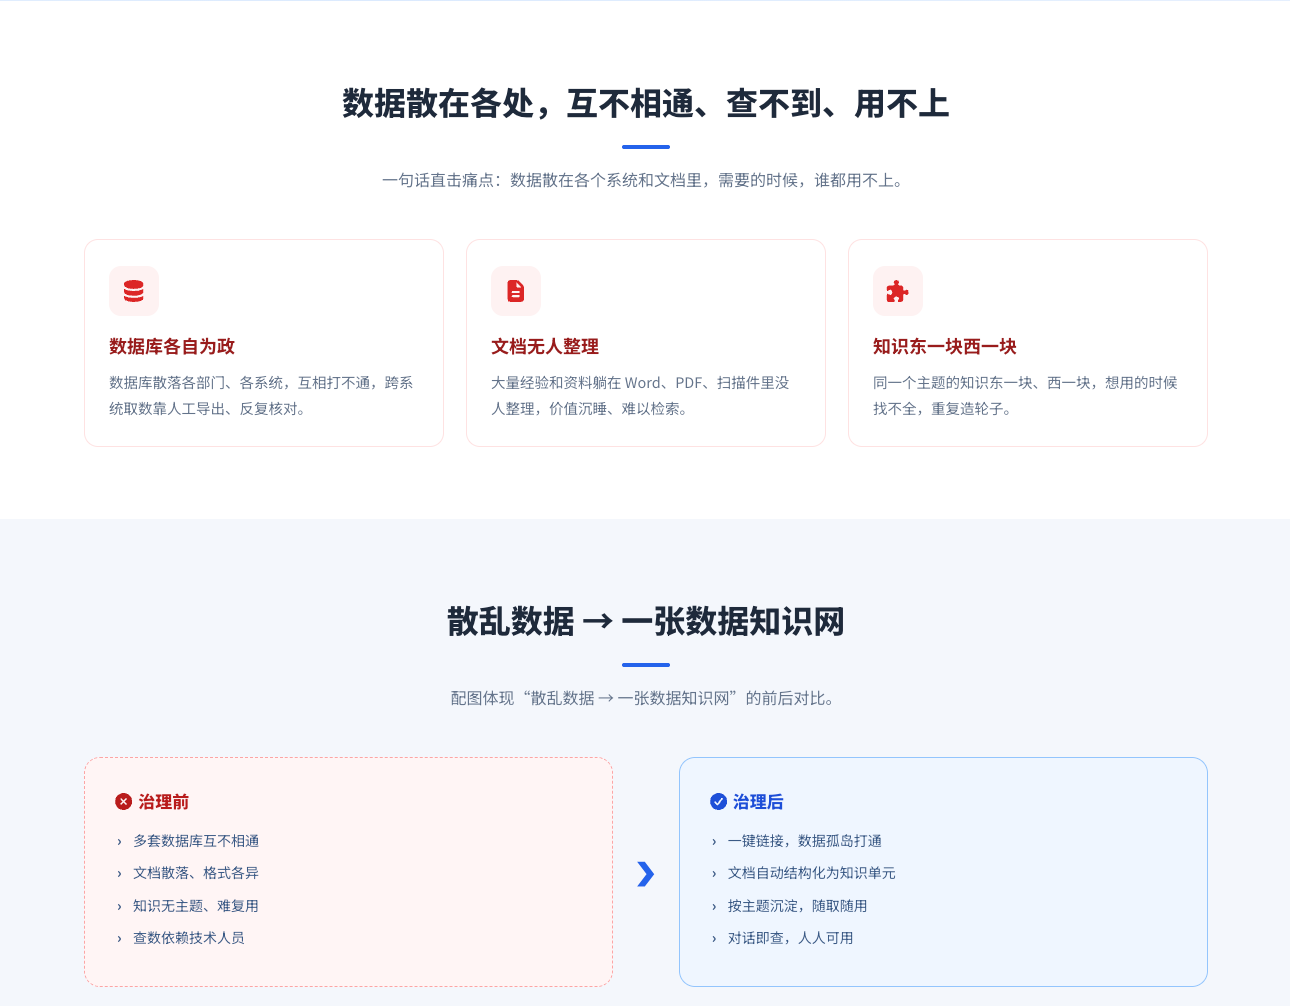
一、数据之痛:数据越攒越多,却越来越用不上
企业不是没有数据,而是数据散在各个系统和文档里,需要的时候谁都用不上。
| 痛点 | 现状描述 |
|---|---|
| 数据库各自为政 | 数据库散落各部门、各系统,互相打不通;跨系统取数靠人工导出、反复核对,口径还经常对不上。 |
| 文档无人整理 | 大量经验和资料躺在 Word、PDF、扫描件里没人整理,价值沉睡、难以检索。 |
| 知识东一块西一块 | 同一主题的知识东一块、西一块,想用时找不全,部门之间重复造轮子。 |
| 数据可信度存疑 | 缺乏统一标准与血缘追溯,数出多门、口径不一,业务和管理层不敢直接用。 |
结论: 数据「存着」不等于「能用」。从一团乱的原始数据,到可信、可查、可复用的知识资产,中间缺的正是「智理」这一环。
二、前后对比:散乱数据 → 一张可信的数据知识网
| 治理前 ❌ | 治理后 ✅ |
|---|---|
| 多套数据库互不相通 | 一键链接,数据孤岛打通 |
| 文档散落、格式各异 | 文档自动结构化为知识单元 |
| 知识无主题、难复用 | 按主题沉淀,随取随用 |
| 数据口径不一、来源不清 | 标准统一、血缘可追溯,数据可信 |
| 查数依赖技术人员 | 对话即查,人人可用 |
三、三大核心能力:聚焦「数据怎么理顺、理好」
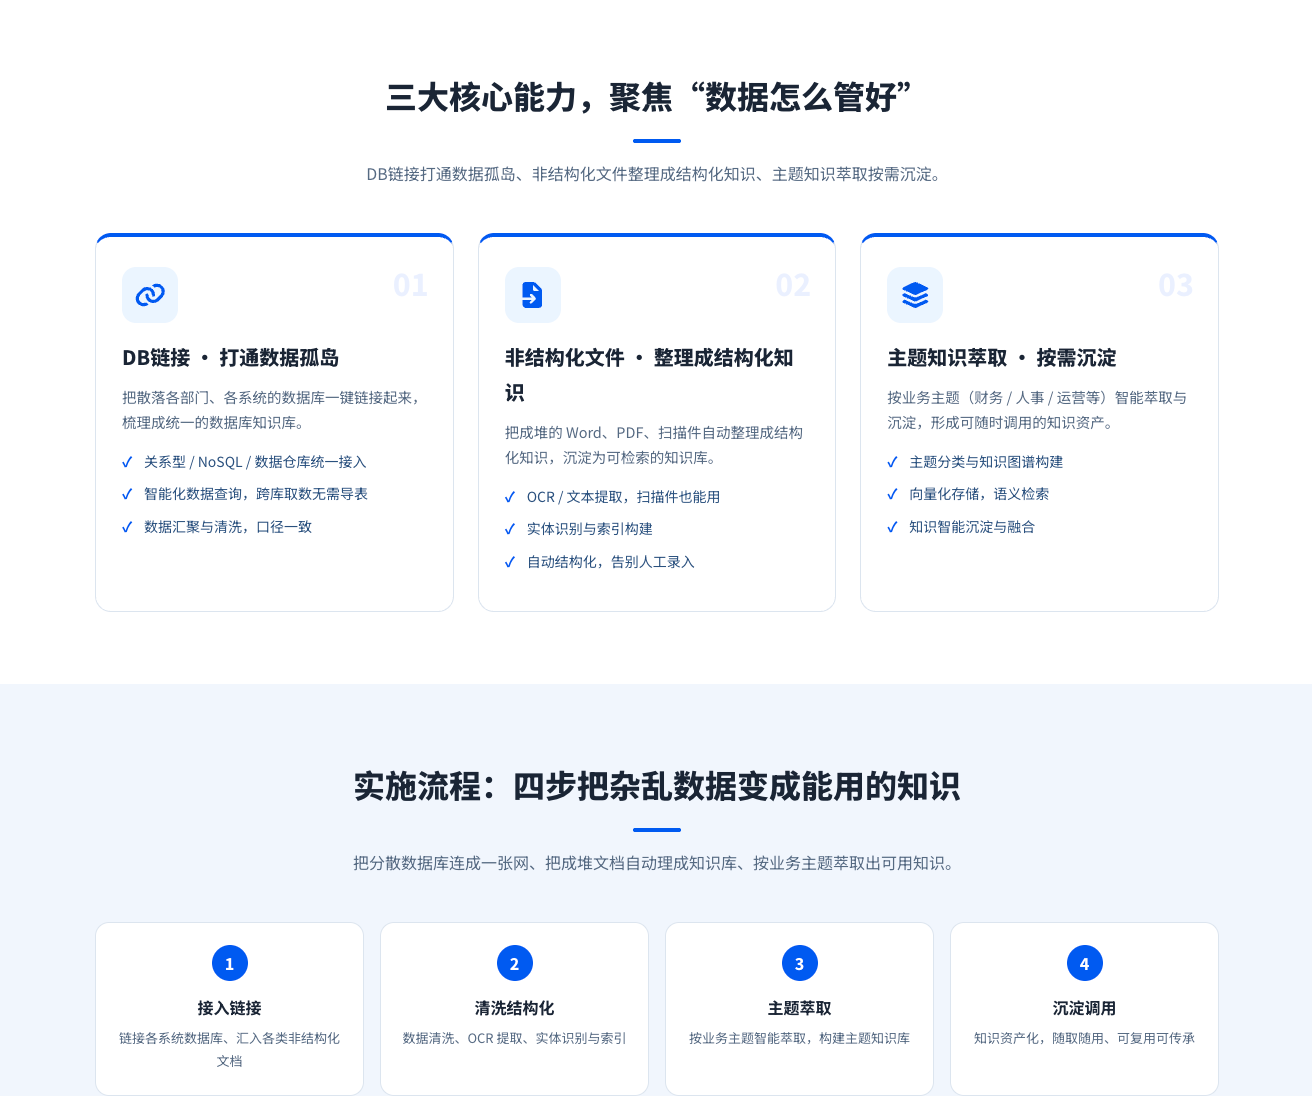
01 · 多源接入 —— 打通数据孤岛
把散落各部门、各系统的数据库与文档一键接入,梳理成统一的数据底座。
· 关系型 / NoSQL / 数据仓库 / API 统一接入
· 结构化与非结构化数据一并汇聚,跨源取数无需导表
· 数据汇聚与清洗,统一口径、去重纠错
02 · 智能清洗与建模 —— 把杂乱数据理成结构化知识
把成堆的脏数据、Word、PDF、扫描件自动清洗、识别、结构化,沉淀为可检索的知识单元。
· OCR / 文本提取,扫描件也能用
· 自动清洗、去噪、标准化,告别人工录入
· 实体识别、关系抽取与索引构建
03 · 主题萃取与血缘贯通 —— 按需沉淀为可信资产
按业务主题(财务 / 人事 / 运营等)智能萃取与沉淀,并保留全链路血缘,形成可信、可追溯、可随时调用的知识资产。
· 主题分类与知识图谱构建
· 向量化存储,支持语义检索
· 数据血缘贯通,来源可追溯、口径可核对
四、实施流程:四步把杂乱数据变成能用的知识
| 步骤 | 名称 | 做什么 |
|---|---|---|
| 1 | 接入链接 | 链接各系统数据库、汇入各类非结构化文档 |
| 2 | 清洗结构化 | 数据清洗、OCR 提取、实体识别与索引 |
| 3 | 主题萃取 | 按业务主题智能萃取,构建主题知识库 |
| 4 | 沉淀贯通 | 知识资产化 + 血缘贯通,随取随用、可复用可传承 |
五、方案价值:从「数据一团乱」到「数据成资产」
· 治理即用 —— 接入即治理,治理即可用,让数据真正流动起来。
· 降本提效 —— 取数、核对、整理不再靠人工,分析师从「找数据」回到「用数据」。
· 资产沉淀 —— 知识按主题持续累积、可传承,避免人走经验走、重复造轮子。
· 决策可信 —— 标准统一、血缘可追溯,业务与管理层敢于直接基于数据决策。